
Limites de Claude et ChatGPT : quotas, fenêtres de 5 heures et tokens expliqués

Dernière vérification : 10 novembre 2026. Les quotas changent souvent : les chiffres qui font foi sont ceux affichés dans votre compte.
Vous lancez une tâche importante et, vingt minutes plus tard, un message annonce que la limite est atteinte. Ce n’est ni une panne ni une erreur de facturation.
Un abonnement à Claude ou à ChatGPT n’achète pas un temps d’utilisation. Il donne accès à une allocation de ressources, renouvelée selon des règles propres à chaque éditeur. Plus une demande est lourde, plus elle consomme vite cette allocation.
Ce guide distingue trois notions souvent confondues :
- Le quota d’abonnement : ce que votre formule permet d’utiliser dans les applications.
- Les tokens : l’unité dans laquelle les modèles lisent et écrivent le texte.
- Les prix de l’API : la facturation à l’usage des développeurs, séparée des abonnements.
Toutes les valeurs fictives sont signalées comme telles. FINIX ne contrôle pas ces quotas et ne peut pas les modifier.
Sommaire
- Les limites de Claude : session de 5 heures et quota hebdomadaire
- Les limites de ChatGPT : Chat, Work et Codex
- Comprendre les tokens : input, output, cached et reasoning
- L’impact de l’historique d’une conversation
- L’influence des modèles sur les quotas
- Pourquoi les prix API ne permettent pas de calculer les quotas
- Pourquoi atteindre 100 % du quota en peu de temps
- Les recommandations FINIX pour réduire la consommation
- Prompts optimisés pour Claude et ChatGPT : avant / après
- Les idées reçues à oublier
- FAQ : limites de Claude et ChatGPT
- Conclusion : utiliser son abonnement IA intelligemment
- Références officielles
Les limites de Claude : session de 5 heures et quota hebdomadaire
Les formules payantes de Claude combinent deux compteurs, sauf Ultra pour les comptes vérifiés. Chacun peut vous arrêter indépendamment de l’autre.
La session de 5 heures
Selon l’aide d’Anthropic, la période commence à votre premier message et la limite se réinitialise entièrement cinq heures plus tard. Le temps restant s’affiche dans Paramètres > Utilisation.
Ces 5 heures indiquent quand l’allocation revient. Elles ne garantissent pas 5 heures de travail. Si tout est consommé en 20 minutes, il faut attendre la fin de la période.
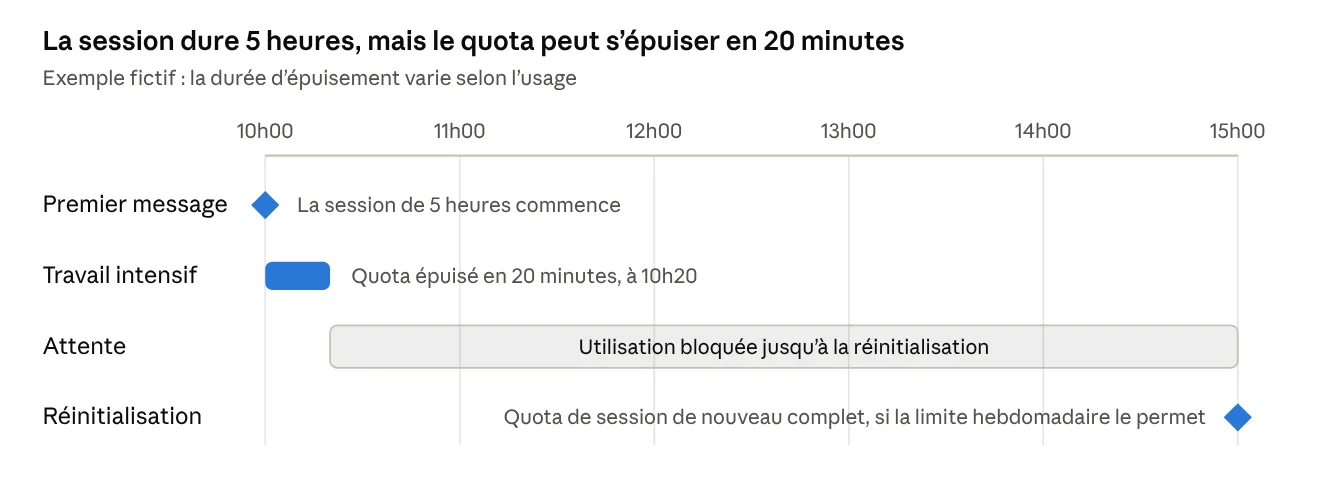
Dans cet exemple fictif, un travail intensif épuise la session dès 10h20. Il faut alors attendre 15h00, même si seules 20 minutes ont été utilisées.
Anthropic cite ces facteurs de consommation : longueur des messages, taille des fichiers, longueur de la conversation, outils, modèle, niveau d’effort, artefacts et tâches à plusieurs étapes.
Le quota hebdomadaire
Il se réinitialise à un moment fixe attribué à votre compte. Ce moment ne dépend ni de votre première utilisation ni de la date de votre abonnement. Il s’applique à tous les modèles.
Deux limites, deux logiques
| Critère | Session de 5 heures | Quota hebdomadaire |
|---|---|---|
| Déclenchement | Votre premier message | Moment fixe lié au compte |
| Réinitialisation | Complète, 5 heures plus tard | Une fois par semaine |
| Rôle | Plafonner l’usage sur 5 heures | Plafonner l’usage de la semaine |
| Formules concernées | Pro, Max ; Ultra si le compte n’est pas vérifié | Pro, Max, Ultra |
| Si elle est atteinte | Attendre la fin de la session | Attendre la réinitialisation hebdomadaire |
Une session réinitialisée ne rend donc pas le quota hebdomadaire. À l’inverse, de la marge sur la semaine ne débloque pas une session épuisée.
Exemple entièrement fictif de consommation sur une semaine :
| Jour | Activité | Part du quota hebdomadaire (fictive) | Cumul (fictif) |
|---|---|---|---|
| Lundi | E-mails et résumés | 6 % | 6 % |
| Mardi | Analyse de deux PDF | 14 % | 20 % |
| Mercredi | Session Claude Code | 35 % | 55 % |
| Jeudi | Recherche approfondie | 20 % | 75 % |
| Vendredi | Nouvelle session Claude Code | 25 % | 100 % : arrêt |
Pro, Max et Ultra
Le tableau reprend les tarifs officiels, hors taxes, pour un abonnement web.
| Formule | Prix officiel | Session de 5 h | Semaine | Modèles Fable |
|---|---|---|---|---|
| Free | 0 $ | Limitée | Limitée | Non inclus |
| Pro | 20 $ par mois | Référence | Référence | Payés en crédits d’usage |
| Max | 100 $ par mois | 5 fois Pro | 5 fois Pro | Jusqu’à 50 % du quota hebdomadaire |
| Ultra | 200 $ par mois | Aucune si le compte est vérifié | 10 fois Pro | Jusqu’à 50 % du quota hebdomadaire |
Anthropic ne publie aucun nombre de messages ou de tokens pour ces multiples. Elle se réserve aussi le droit d’ajuster les limites.
De Claude Max 20x à Claude Ultra
Anthropic l’indique clairement : la formule Max 20x s’appelle désormais Ultra. Les abonnés existants y passent automatiquement, sans changement de prix.
Trois points méritent votre attention :
- Le chiffre a changé de nature. Ultra offre 10 fois l’usage hebdomadaire de Pro. Le nom « 20x » ne doit plus servir de repère.
- La session disparaît sous condition. Un compte Ultra vérifié n’a pas de limite de 5 heures. Un compte non vérifié garde une limite temporaire.
- La vérification est automatique. Elle repose sur des critères comme l’historique du compte et des paiements. Valider son numéro de téléphone ne suffit pas. Sans barre « session en cours » dans vos réglages, le compte est vérifié.
De son côté, la formule à 100 $ s’appelle simplement Max : l’appellation « Max 5x » n’apparaît plus dans les pages officielles consultées.
Ce qui partage le même quota
Claude, Claude Code et Claude Desktop comptent dans la même limite. Pour Cowork, Anthropic précise que tout ce que vous faites avec Claude compte dans les limites de votre formule.
Sur Max et Ultra, les modèles Fable puisent dans le quota hebdomadaire, plus vite que les autres, dans la limite de 50 %. Ce plafond ne s’ajoute pas au quota.
Ne confondez pas la limite d’utilisation, qui porte sur l’ensemble de vos conversations, et la limite de longueur, qui porte sur une seule conversation.
Claude Chat et Claude Code
Le quota est commun, mais la consommation diffère. Dans Claude Code, chaque tour renvoie la conversation, le contexte du projet et votre nouvelle demande.
Attention : si la variable ANTHROPIC_API_KEY est définie, Claude Code utilise cette clé et vous facture au tarif de l’API. À la limite, vous pouvez attendre, changer de formule ou activer les crédits d’usage, facturés au tarif de l’API.
Les limites de ChatGPT : Chat, Work et Codex
ChatGPT regroupe trois usages aux règles différentes. Les confondre est la première source d’erreur.
- Chat : les questions et les échanges.
- ChatGPT Work : les tâches qui produisent un résultat à relire.
- Codex : le travail de développement.
OpenAI indique que Work et Codex partagent les mêmes tarifs, crédits et limites. Les limites du Chat sont présentées à part sur la page des formules.
Free, Go, Plus et Pro
| Formule | Prix officiel | Chat | Work et Codex |
|---|---|---|---|
| Free | 0 $ | Texte annoncé « illimité » sous garde-fous ; fichiers, images et voix limités | Accès limité, tâches de code rapides |
| Go | 8 $ par mois | Comme Free, avec plus d’outils, de fichiers et d’images ; peut inclure de la publicité | Tâches de code légères |
| Plus | 20 $ par mois | Modèles de raisonnement avancés, projets, tâches planifiées, GPT personnalisés | Quelques sessions ciblées par semaine ; quota par 5 heures |
| Pro | 100, 200 ou 500 $ par mois | Raisonnement Pro, recherche approfondie maximale | Sessions plus longues ; pas de limite sur 5 heures à ce jour |
Le mot « illimité » est celui d’OpenAI. Il concerne le texte courant, sous réserve d’un usage raisonnable et conforme à ses règles. OpenAI ne publie pas de nombre de messages pour le Chat.
La quantité de texte exploitable varie aussi selon la formule, d’après la page des formules :
| Contexte total | Free | Go | Plus | Pro |
|---|---|---|---|---|
| Réponses instantanées | 27 000 tokens | 54 000 | 54 000 | 128 000 |
| Raisonnement | Variable | 256 000 | 256 000 | 400 000 |
Les quotas de Work et Codex
OpenAI publie des estimations en messages locaux par période de 5 heures pour Plus et Business Standard. Elle précise qu’il ne s’agit pas de limites fixes.
| Modèle | Messages locaux estimés par 5 h |
|---|---|
| GPT-6 Astra | 5 à 45 |
| GPT-6.1 Sol | 15 à 160 |
| GPT-6 Sol | 15 à 150 |
| GPT-6.1 Terra | 35 à 285 |
| GPT-6 Luna | 350 à 3 000 |
Messages locaux et tâches dans le cloud partagent la même allocation, et les tâches dans le cloud peuvent consommer davantage. Des limites hebdomadaires peuvent aussi s’appliquer.
Sur Pro, OpenAI indique qu’il n’existe actuellement pas de limite sur 5 heures. Les limites à jour et les heures de réinitialisation se lisent dans votre tableau d’usage, ou avec /status dans le terminal.
Niveaux de raisonnement et vitesse
Dans Work et Codex, les niveaux vont de Light à Ultra : Light, Medium, High, Extra High, Max et Ultra. Max donne plus de temps de réflexion, Ultra répartit le travail entre plusieurs sous-agents.
Certains réglages accélèrent la consommation. Selon OpenAI, le mode Fast utilise 2,5 fois l’allocation du mode standard, et Ultrafast, réservé à Pro à 500 $, 8 fois. Les images épuisent l’allocation en moyenne 3 à 5 fois plus vite.
Au-delà du quota, Plus et Pro peuvent acheter des crédits. Il est aussi possible d’utiliser une clé API, facturée au tarif de l’API.
Claude et ChatGPT : les différences
| Critère | Claude | ChatGPT |
|---|---|---|
| Portée | Chat, Claude Code, Desktop et Cowork dans les limites de la formule | Work et Codex partagent une allocation ; le Chat a ses propres limites |
| Fenêtre de 5 heures | Pro et Max ; pas pour Ultra vérifié | Work et Codex sur Plus ; pas sur Pro |
| Semaine | Moment fixe attribué au compte | « Peuvent s’appliquer » ; voir le tableau d’usage |
| Au-delà du quota | Crédits d’usage | Crédits sur Plus et Pro |
| Crédits API mensuels | Max et Ultra, inutilisables dans les applications | Pro et Business éligibles, sans effet sur les quotas |
Comprendre les tokens : input, output, cached et reasoning
Un token est un petit morceau de texte que le modèle lit ou écrit. Ce n’est ni un mot ni un caractère : son découpage dépend du modèle.
| Type de token | Ce que c’est | Ce qu’il faut savoir |
|---|---|---|
| Input (entrée) | Tout ce que le modèle reçoit | Inclut instructions, messages, résultats d’outils, images et documents |
| Output (sortie) | Le texte généré | Dans l’API, il coûte plus cher que l’entrée |
| Cached (en cache) | Une entrée déjà traitée, réutilisée à l’identique | Exige une correspondance exacte du début de la demande chez OpenAI et Anthropic |
| Reasoning (raisonnement) | La réflexion interne avant la réponse | Invisible mais facturée en sortie, de quelques centaines à des dizaines de milliers de tokens |
Dans les projets Claude, le contenu en cache compte moins dans vos limites. Le cache expire après une période d’inactivité : après une longue pause, le premier message compte ce contenu en entier.
La fenêtre de contexte désigne la quantité d’information utilisable en une fois. Elle ne se confond pas avec le quota : une demande peut tenir dans le contexte et être refusée parce que le quota est épuisé.
Ce que contient vraiment une demande
Exemple fictif d’un message de 200 tokens dans une conversation déjà avancée :
| Composant | Tokens (fictif) | Type |
|---|---|---|
| Instructions de l’application | 1 000 | Input |
| Historique de la conversation | 8 000 | Input, en partie en cache |
| Fichier joint | 5 000 | Input |
| Votre message | 200 | Input |
| Réflexion du modèle | 1 500 | Reasoning |
| Réponse affichée | 500 | Output |
| Total | 16 200 |
Vous ne voyez que votre message et la réponse, soit 700 tokens sur 16 200 dans cet exemple. C’est pourquoi un échange qui semble court peut peser lourd.
Comment le prompt change la consommation
Exemple fictif : le même e-mail, obtenu de deux façons.
| Méthode | Déroulement | Tokens (fictif) |
|---|---|---|
| Prompt vague et deux corrections | 3 tours : le modèle relit à chaque fois ses longues réponses précédentes | 4 980 |
| Prompt précis, une seule réponse | 150 tokens lus, 400 tokens produits | 550 |
Cet écart ne vaut pas règle. Sur une tâche complexe, un prompt plus long et mieux documenté consomme davantage au départ, et peut éviter plusieurs reprises.
Tokenisation selon la langue
Le même message ne donne pas le même nombre de tokens partout. Anthropic indique que ses tokenizers récents produisent environ 30 % de tokens de plus pour le même texte que les précédents. OpenAI prévient que les estimations du type « caractères divisés par 4 » sont inexactes.
Ordres de grandeur illustratifs, non mesurés :
| Langue | Phrase | Ordre de grandeur |
|---|---|---|
| Anglais | Please summarize this document. | Environ 5 à 8 tokens |
| Français | Merci de résumer ce document. | Environ 7 à 10 tokens |
| Arabe | يرجى تلخيص هذا المستند. | Environ 8 à 20 tokens |
Les éditeurs ne publient pas de coefficient par langue pour leurs abonnements. Un token n’a pas non plus le même poids partout : 1 000 tokens d’un petit modèle rapide ne mobilisent pas les mêmes ressources que 1 000 tokens d’un modèle de pointe en réflexion approfondie.
L’impact de l’historique d’une conversation
L’historique est souvent le premier poste de consommation. À chaque tour, le modèle travaille sur ce qui précède : la charge grandit donc plus vite que le nombre de messages.
Exemple fictif : chaque échange ajoute 500 tokens. Le message 100 relit 50 000 tokens, et les 100 lectures cumulées atteignent 500 × (1 + 2 + … + 100), soit 2 525 000 tokens.
| Scénario (fictif) | Tokens d’historique lus au total |
|---|---|
| Une seule conversation de 100 échanges | 2 525 000 |
| 4 conversations de 25 échanges, reprises avec un résumé de 500 tokens | 687 500 |
Deux réserves s’appliquent. Le cache peut réduire le poids de l’historique tant qu’il n’a pas expiré. Et un résumé trop court peut faire perdre des détails utiles.
Anthropic précise aussi que les conversations qui déclenchent la gestion automatique du contexte consomment davantage, et conseille d’ouvrir une nouvelle conversation si vous approchez de votre limite. Dans Claude Code, l’historique est ce qui grandit le plus vite.
L’influence des modèles sur les quotas
Le modèle choisi change le rythme de consommation. Anthropic indique par exemple qu’Opus utilise sensiblement plus de quota dans Claude Code, et que les modèles Fable consomment plus vite que les autres.
Modèles Claude
Descriptions et latences d’après la documentation d’Anthropic. Les colonnes d’usage sont nos recommandations.
| Modèle | Points forts et complexité | Latence | Inutilement puissant pour |
|---|---|---|---|
| Claude Fable 5.2 | Raisonnement exigeant, tâches agentiques longues | Modérée | E-mails, traductions, résumés courants |
| Claude Opus 5.5 | Programmation agentique longue, travail intellectuel | Modérée | Reformulations, questions factuelles |
| Claude Sonnet 5.5 | Meilleur équilibre vitesse et intelligence | Rapide | Tri ou extraction en volume |
| Claude Haiku 5.5 | Classement, extraction, routage | La plus rapide | Rarement : il sera plutôt insuffisant sur les tâches complexes |
Sonnet et Haiku sont inclus dès Free, Opus dès Pro. Fable est inclus sur Max et Ultra, et payable en crédits sur Pro.
Modèles de Work et Codex
La consommation reprend les estimations d’OpenAI pour Plus. OpenAI ne publie pas de comparaison de vitesse entre ces modèles.
| Modèle | Usage recommandé | Messages estimés par 5 h | Inutilement puissant pour |
|---|---|---|---|
| GPT-6 Astra | Tâches les plus difficiles | 5 à 45 | Le code de routine |
| GPT-6.1 Sol | Programmation et travail complexes | 15 à 160 | Les corrections mineures |
| GPT-6.1 Terra | Développement courant | 35 à 285 | Les tâches répétitives simples |
| GPT-6 Luna | Usage quotidien, volume | 350 à 3 000 | Rarement : il sera plutôt insuffisant sur les tâches complexes |
GPT-6.1 Sol et GPT-6.1 Terra sont disponibles dans Work et Codex, pas dans le Chat. La liste exacte des modèles du Chat varie selon la formule : consultez le sélecteur de votre compte.
Quand préférer un modèle économique
| Tâche | Choix recommandé | Pourquoi |
|---|---|---|
| Corriger l’orthographe, reformuler | Économique (Haiku, Luna) | Peu de raisonnement requis |
| Classer ou extraire des données | Économique | Tâche répétitive et bien définie |
| Rédiger un e-mail, résumer un texte | Économique ou équilibré (Sonnet, Terra) | Le résultat se vérifie vite |
| Rédiger un article, analyser un document | Équilibré | Il faut de la structure et de la nuance |
| Corriger un bug difficile, concevoir une architecture | Avancé (Opus, Sol) | Une erreur coûte plusieurs reprises |
| Mener une tâche longue et autonome | Avancé (Fable, Astra) | Il faut tenir le fil sur de nombreuses étapes |
Notre règle : commencez par le modèle le plus léger qui peut raisonnablement réussir, et montez d’un cran si le résultat est insuffisant. Baissez aussi le niveau d’effort pour les tâches courantes. Attention : un modèle trop faible qui oblige à recommencer finit par coûter plus cher.
Pourquoi les prix API ne permettent pas de calculer les quotas
OpenAI le dit explicitement : les prix des tokens de l’API sont distincts de l’usage de l’abonnement et ne servent pas à estimer les tâches incluses. Anthropic ne publie pas non plus de telle équivalence.
Les chiffres officiels le montrent. Dans l’API OpenAI, GPT-6 Astra coûte 5 fois le prix de GPT-6.1 Sol. Pourtant, les estimations de Work et Codex ne donnent qu’un écart d’environ 3 à 3,6 entre leurs nombres de messages.
| Ce qu’on observe | API | Abonnement |
|---|---|---|
| Unité | Dollars par million de tokens | Allocation interne non publiée |
| Mesure | Tokens réellement facturés | Jauge en pourcentage ou estimation |
| Variables | Modèle, cache, type de token | Modèle, effort, outils, cache, capacité |
| Paiement | À l’usage | Forfait, puis crédits éventuels |
Les tarifs de l’API Claude placent Opus 5.5 à deux fois le prix de Sonnet 5.5. Rien n’indique qu’il consomme exactement deux fois plus de quota. Anthropic peut aussi ajuster les limites pour gérer la capacité.
Enfin, les crédits API inclus dans certaines formules ne changent pas vos quotas. C’est vrai pour les crédits de Max et Ultra comme pour ceux de ChatGPT Pro et Business.
Pourquoi atteindre 100 % du quota en peu de temps
La cause est rarement un message isolé : c’est l’accumulation de contexte, d’outils et d’étapes.
Exemple entièrement fictif avec une allocation imaginaire de 1 000 unités :
| Action | Durée (fictive) | Unités (fictives) | Cumul |
|---|---|---|---|
| Question simple | 1 min | 2 | 2 |
| Analyse d’un PDF | 3 min | 60 | 62 |
| Agent de programmation, 30 tours à 25 unités | 12 min | 750 | 812 |
| Recherche approfondie | 4 min | 188 | 1 000 : arrêt |
Dans cet exemple, vingt minutes suffisent, et l’agent pèse à lui seul les trois quarts du total. Les causes les plus fréquentes sont :
- Les agents et la programmation : Claude Code et Codex lisent des fichiers, lancent des commandes, corrigent et recommencent.
- Les documents et les PDF volumineux : ils restent dans le contexte de la conversation.
- Les images : elles consomment des tokens selon leur taille et leur niveau de détail.
- La recherche web et les connecteurs : les résultats reviennent dans le contexte.
- Le raisonnement approfondi : un niveau d’effort plus élevé utilise plus de tokens.
- Les relances : recommencer une tâche repaie tout le traitement.
Les recommandations FINIX pour réduire la consommation
L’objectif n’est pas de moins demander, mais d’éviter le travail inutile. Ces conseils peuvent réduire la consommation, sans jamais la garantir. Plusieurs reprennent les recommandations d’Anthropic.
| Conseil | Comment faire | Pourquoi cela aide | Quand cela ne marche pas |
|---|---|---|---|
| 1. Choisir le bon modèle | Commencer léger, monter si besoin | Un modèle plus léger consomme généralement moins | Tâche complexe : il faudra recommencer |
| 2. Ajuster le niveau d’effort | Effort bas pour les tâches courantes | Moins de tokens de raisonnement | Problème réellement difficile |
| 3. Être précis dès le départ | Objectif, public, format, longueur | Moins de corrections | Exploration libre |
| 4. Regrouper les demandes liées | Une seule demande structurée | Le contexte n’est lu qu’une fois | Sujets sans rapport |
| 5. Relire son prompt avant l’envoi | Vérifier qu’il ne manque rien | Évite un tour de correction | Aucune limite notable |
| 6. Limiter la longueur des réponses | « En 100 mots », « sans introduction » | Moins de tokens de sortie | Besoin réel d’un texte long |
| 7. Joindre seulement l’utile | Extraire les pages concernées | Moins de contenu à analyser | L’analyse exige le document complet |
| 8. Ouvrir une nouvelle conversation | Quand le sujet change | L’historique repart de zéro | Le contexte reste nécessaire |
| 9. Résumer avant de repartir | Demander un résumé, le coller ailleurs | Un résumé remplace un long historique | Des détails exacts disparaissent |
| 10. Utiliser les projets | Documents de référence dans le projet | Le contenu réutilisé compte moins | Documents qui changent sans cesse |
| 11. Travailler sans longues pauses | Enchaîner les demandes sur un même contenu | Le cache reste actif | Le cache expire après inactivité |
| 12. Désactiver les outils inutiles | Retirer connecteurs et recherche web | Moins de définitions et d’appels | La tâche dépend de ces outils |
| 13. Planifier avant d’exécuter | Demander un plan, puis valider | Moins de fausses pistes | Problème impossible à cadrer |
| 14. Vérifier sa jauge avant un gros travail | Paramètres > Utilisation, /status | Évite une coupure en plein milieu | Aucune économie directe |
| 15. Ne pas relancer sans raison | Corriger ciblé plutôt que tout refaire | Chaque relance repaie tout | Une erreur grave impose de refaire |
Prompts optimisés pour Claude et ChatGPT : avant / après
Un bon prompt évite surtout les allers-retours. L’économie dépend de la tâche : nous ne donnons donc aucun pourcentage.
1. Marketing dans Claude
- Avant : « Fais-moi un post pour mon produit. »
- Problème : ni canal, ni cible, ni ton.
- Après : « Rédige un post Facebook de 80 mots pour des parents à Tunis, ton chaleureux, sur [produit], avec un seul appel à l’action. Propose 2 variantes. »
- Pourquoi : le résultat est cadré dès la première réponse.
- Économie potentielle : moins de reformulations.
2. E-mail dans ChatGPT
- Avant : « Écris un mail au client. », puis trois corrections.
- Problème : chaque correction relit l’historique.
- Après : « Écris un e-mail de 90 mots, ton professionnel, pour annoncer un retard de 3 jours et proposer un geste commercial. Donne uniquement l’e-mail. »
- Pourquoi : une seule demande suffit souvent.
- Économie potentielle : moins d’échanges et de texte superflu.
3. Correction de bug dans Claude Code
- Avant : « Mon site bugue, regarde tout le projet. »
- Problème : l’agent lit de nombreux fichiers sans piste.
- Après : « Dans
panier.php, le total ignore la remise. Voici l’erreur : […]. Propose une correction minimale de ce fichier, sans modifier les autres. » - Pourquoi : le périmètre est limité.
- Économie potentielle : moins de fichiers lus et d’appels d’outils.
4. Nouvelle fonction dans Codex
- Avant : « Ajoute un système de coupons. »
- Problème : les choix implicites provoquent des retours en arrière.
- Après : « Propose d’abord un plan en 5 points pour des coupons à pourcentage fixe. N’écris aucun code avant ma validation. »
- Pourquoi : une erreur de conception se corrige avant le code.
- Économie potentielle : moins de code à réécrire.
5. Document dans un projet Claude
- Avant : joindre un rapport de 200 pages à chaque nouvelle conversation et demander « résume ».
- Problème : tout le document est retraité pour un besoin partiel.
- Après : placer le rapport dans un projet, puis demander « Dans le chapitre 3, liste les 5 obligations légales, avec leur page. »
- Pourquoi : le contenu réutilisé peut être mis en cache, et la question est ciblée.
- Économie potentielle : moins de contenu compté en entier.
6. Analyse de données dans ChatGPT
- Avant : « Analyse ce fichier Excel. »
- Problème : l’objectif est ouvert et l’analyse se disperse.
- Après : « Compare le chiffre d’affaires mensuel 2025 et 2026 par catégorie, et donne les 3 plus fortes baisses dans un tableau. »
- Pourquoi : une question, une sortie attendue.
- Économie potentielle : moins d’étapes d’analyse.
7. Rédaction longue dans Claude
- Avant : « Écris un guide complet sur la cybersécurité. »
- Problème : sujet immense, réponse probablement à refaire.
- Après : « Propose un plan H2/H3 pour un guide de 1 500 mots destiné aux petites boutiques en ligne. J’indiquerai ensuite les sections à rédiger. »
- Pourquoi : le plan se valide à faible coût.
- Économie potentielle : moins de texte long à régénérer.
8. Traduction dans ChatGPT
- Avant : coller le même texte en demandant successivement l’anglais, puis l’arabe.
- Problème : deux demandes, deux lectures.
- Après : « Traduis ce texte en anglais et en arabe, en gardant les noms de produits, dans un tableau à deux colonnes. »
- Pourquoi : le texte source n’est envoyé qu’une fois.
- Économie potentielle : moins de contexte relu.
Les idées reçues à oublier
- « J’ai payé, donc c’est illimité. » Faux. Les formules payantes augmentent l’allocation sans la supprimer.
- « 5 heures signifie 5 heures de travail. » Faux. C’est le délai avant la réinitialisation.
- « Un message correspond à une quantité fixe de tokens. » Faux. Un message peut relire un long historique ou déclencher des outils.
- « Une réponse courte ne consomme presque rien. » Faux. La lecture du contexte et le raisonnement comptent aussi.
- « Changer de modèle réinitialise mon quota. » Faux. Le changement modifie le rythme de consommation. Sur Claude, quitter Fable permet seulement de continuer si seule la limite Fable est atteinte.
- « Supprimer mes conversations restaure mes limites. » Aucune page officielle consultée ne l’indique.
- « Un nouveau chat réinitialise la semaine. » Faux. Il peut seulement réduire la consommation à venir.
- « Un abonnement ChatGPT inclut des crédits API. » Pas automatiquement. Seuls certains abonnements Pro et Business peuvent en réclamer, sous conditions.
FAQ : limites de Claude et ChatGPT
Où voir mes limites restantes ?
Sur Claude, dans Paramètres > Utilisation. Sur Codex, dans le tableau d’usage ou avec /status.
Quelle formule Claude choisir ?
Pro pour un usage régulier, Max si vous atteignez souvent les limites de Pro, Ultra pour un usage très intensif.
J’avais Claude Max 20x : que devient mon abonnement ?
Il passe automatiquement à Ultra, sans changement de prix, selon Anthropic.
Que signifie « compte Ultra vérifié » ?
Anthropic a confirmé automatiquement le compte. Il n’a alors plus de limite de 5 heures.
Les modèles Fable sont-ils inclus dans Claude Pro ?
Non. Sur Pro, ils sont payés avec des crédits d’usage.
Que sont les crédits d’usage de Claude ?
Un paiement à l’usage, au tarif de l’API, qui permet de continuer au-delà des limites.
Claude Code peut-il terminer une réponse à la limite ?
Parfois, avec une marge réduite et plafonnée. Cette fonction est en cours de déploiement.
Une clé API utilise-t-elle mon abonnement ?
Non. Une clé API est facturée au tarif de l’API, chez Anthropic comme chez OpenAI.
Les crédits API de Claude Max servent-ils dans Claude Code ?
Non. Ils ne couvrent pas l’usage interactif de Claude Code ni les applications.
ChatGPT Plus suffit-il pour Codex ?
OpenAI le présente comme adapté à quelques sessions ciblées par semaine.
ChatGPT Pro a-t-il une limite de 5 heures dans Codex ?
Non, pas actuellement, selon OpenAI. Des limites hebdomadaires peuvent toutefois s’appliquer.
Le Chat consomme-t-il le quota de Codex ?
OpenAI présente les limites du Chat séparément. Work et Codex, eux, partagent leur allocation.
Les images consomment-elles beaucoup ?
Dans Work et Codex, elles épuisent l’allocation en moyenne 3 à 5 fois plus vite.
L’arabe consomme-t-il plus que l’anglais ?
Cela dépend du tokenizer. Aucun coefficient officiel n’est publié pour les abonnements.
FINIX peut-il augmenter mon quota ?
Non. Les quotas dépendent uniquement d’Anthropic et d’OpenAI.
Conclusion : utiliser son abonnement IA intelligemment
Un abonnement IA se gère comme un budget : l’allocation dépend de la formule, son rythme dépend de vos usages. Nous vous conseillons de choisir le modèle adapté, de garder un contexte léger et de consulter votre jauge avant un travail important.
Pour comparer les offres, consultez nos catégories Anthropic et OpenAI, ou notre guide ChatGPT Go, Plus ou Pro.
Références officielles
Pages consultées le 10 novembre 2026.
Anthropic
- Limites d’utilisation et de longueur
- Formule Pro, formule Max, formule Ultra, tarifs
- Modèles Fable selon la formule
- Claude Code avec un abonnement, modèles et limites dans Claude Code
- Bonnes pratiques d’utilisation, Cowork et chat
- Crédits d’usage, crédits API mensuels
- API : modèles, tarifs, contexte, cache, comptage des tokens
OpenAI
Articles similaires

ChatGPT Go vs Plus vs Pro : quel abonnement choisir en Tunisie en 2026 ?
Go, Plus ou Pro : comparatif des fonctions, des limites et des prix en Tunisie, avec nos conseils selon votre profil.